GoForum › 🌐 V2EX

听劝!我把 FreeAudioToText 打包成了完全离线的 Docker 版,还加了声纹识别(发福利)
iyuanyi ·
2026-08-26 13:53 ·
0 次点赞 · 0 条回复
7 月 1 号我把 FreeAudioToText.com 上线后,每天都有不少老哥来转音频。在这个过程中收集到了两个最痛点的反馈:
- 隐私问题:公司开会、私密录音,实在不敢往云端传,怕泄露。
- 声纹识别:光有文字不行,得知道具体是谁说的话。
结合大家的建议,我干脆把整个大模型( Whisper + 声纹模型)全塞进了一个 Docker 镜像里。完全不联网也能跑,数据绝对安全。
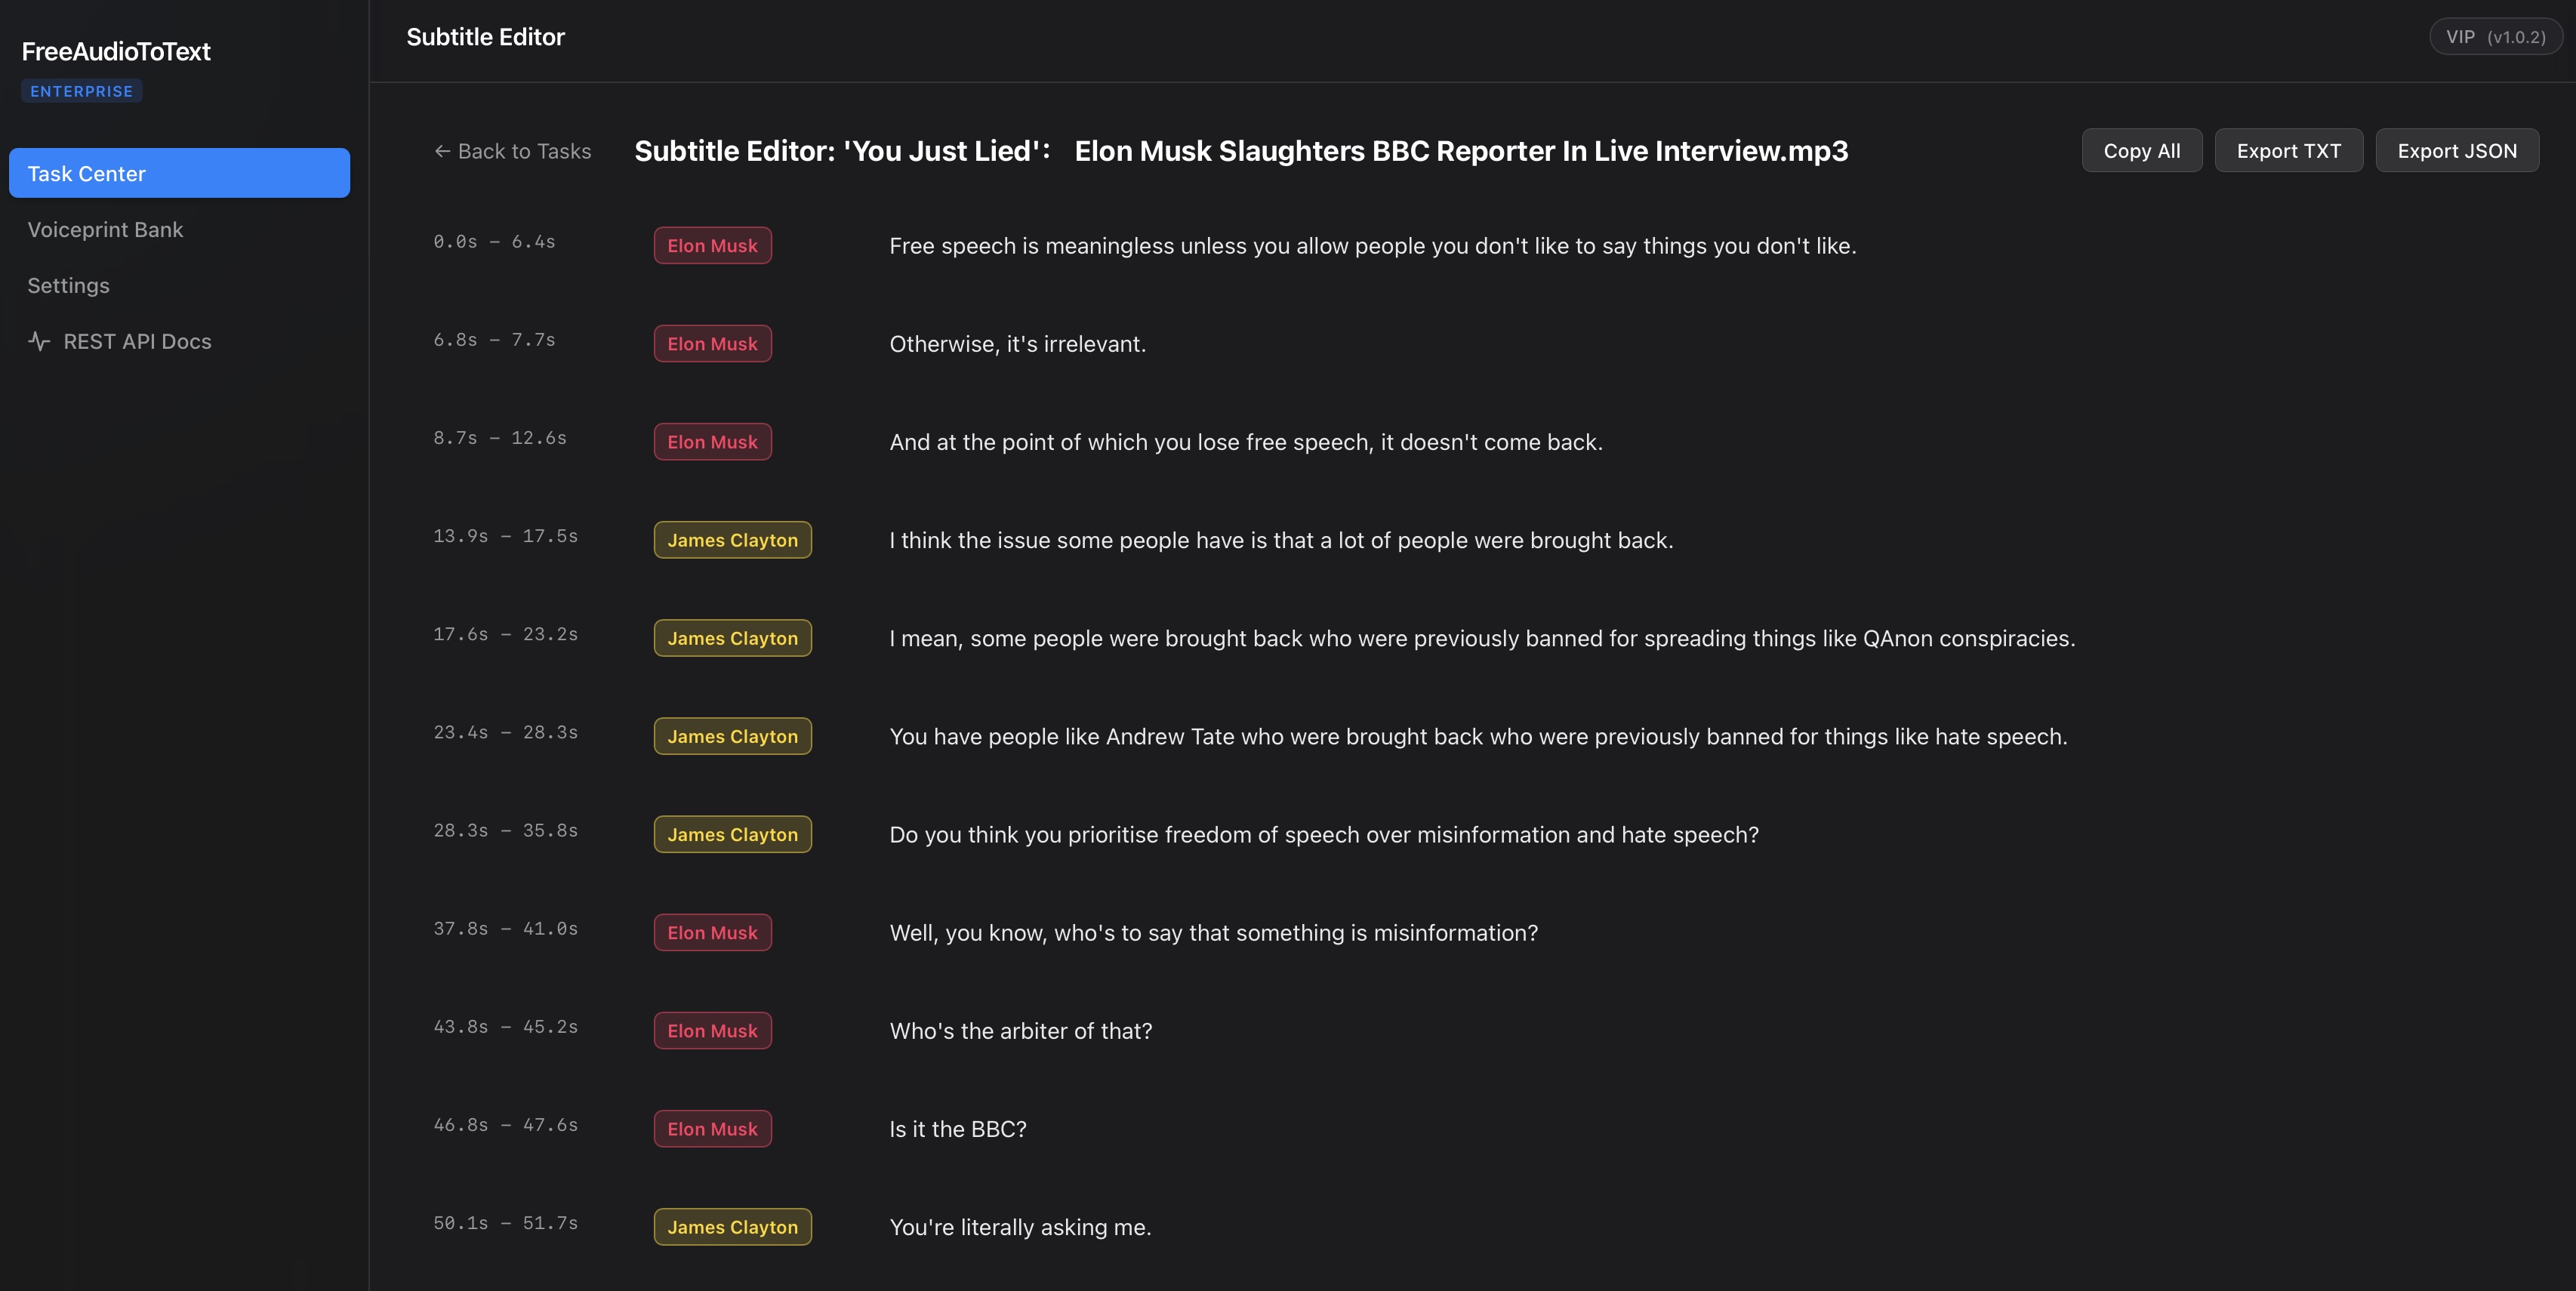
因为塞了完整的大模型,所以镜像有点大,大概 20G 左右。随便找个带显卡的机器 load 一下就能用。
👀 具体详情看这里: https://freeaudiototext.com/enterprise
🎁 发点福利: 这个版本本来是做给企业客户的,但 V 站老哥们提了不少好建议。有兴趣折腾的朋友直接在楼下留邮箱,我直接送激活 License 给你们玩玩!
0 条回复
添加回复
你还需要 登录
后发表回复